
Overview
La vidéo REX-AI : Ma routine de travail avec l’IA (une organisation pour débuter), publiée par la chaîne xavki le 13 septembre 2026, décrit une routine quotidienne centrée sur l’adoption d’une méthode plutôt que sur l’accumulation d’outils. Cette priorité est posée dès 05:05. La stack montrée associe notamment Notion, OpenCode, Mistral Vibe CLI et un outil de workspace qui semble être cmux (06:35). Cette dernière identification reste probable, pas certaine, car elle repose sur les éléments visibles et cités dans la vidéo.
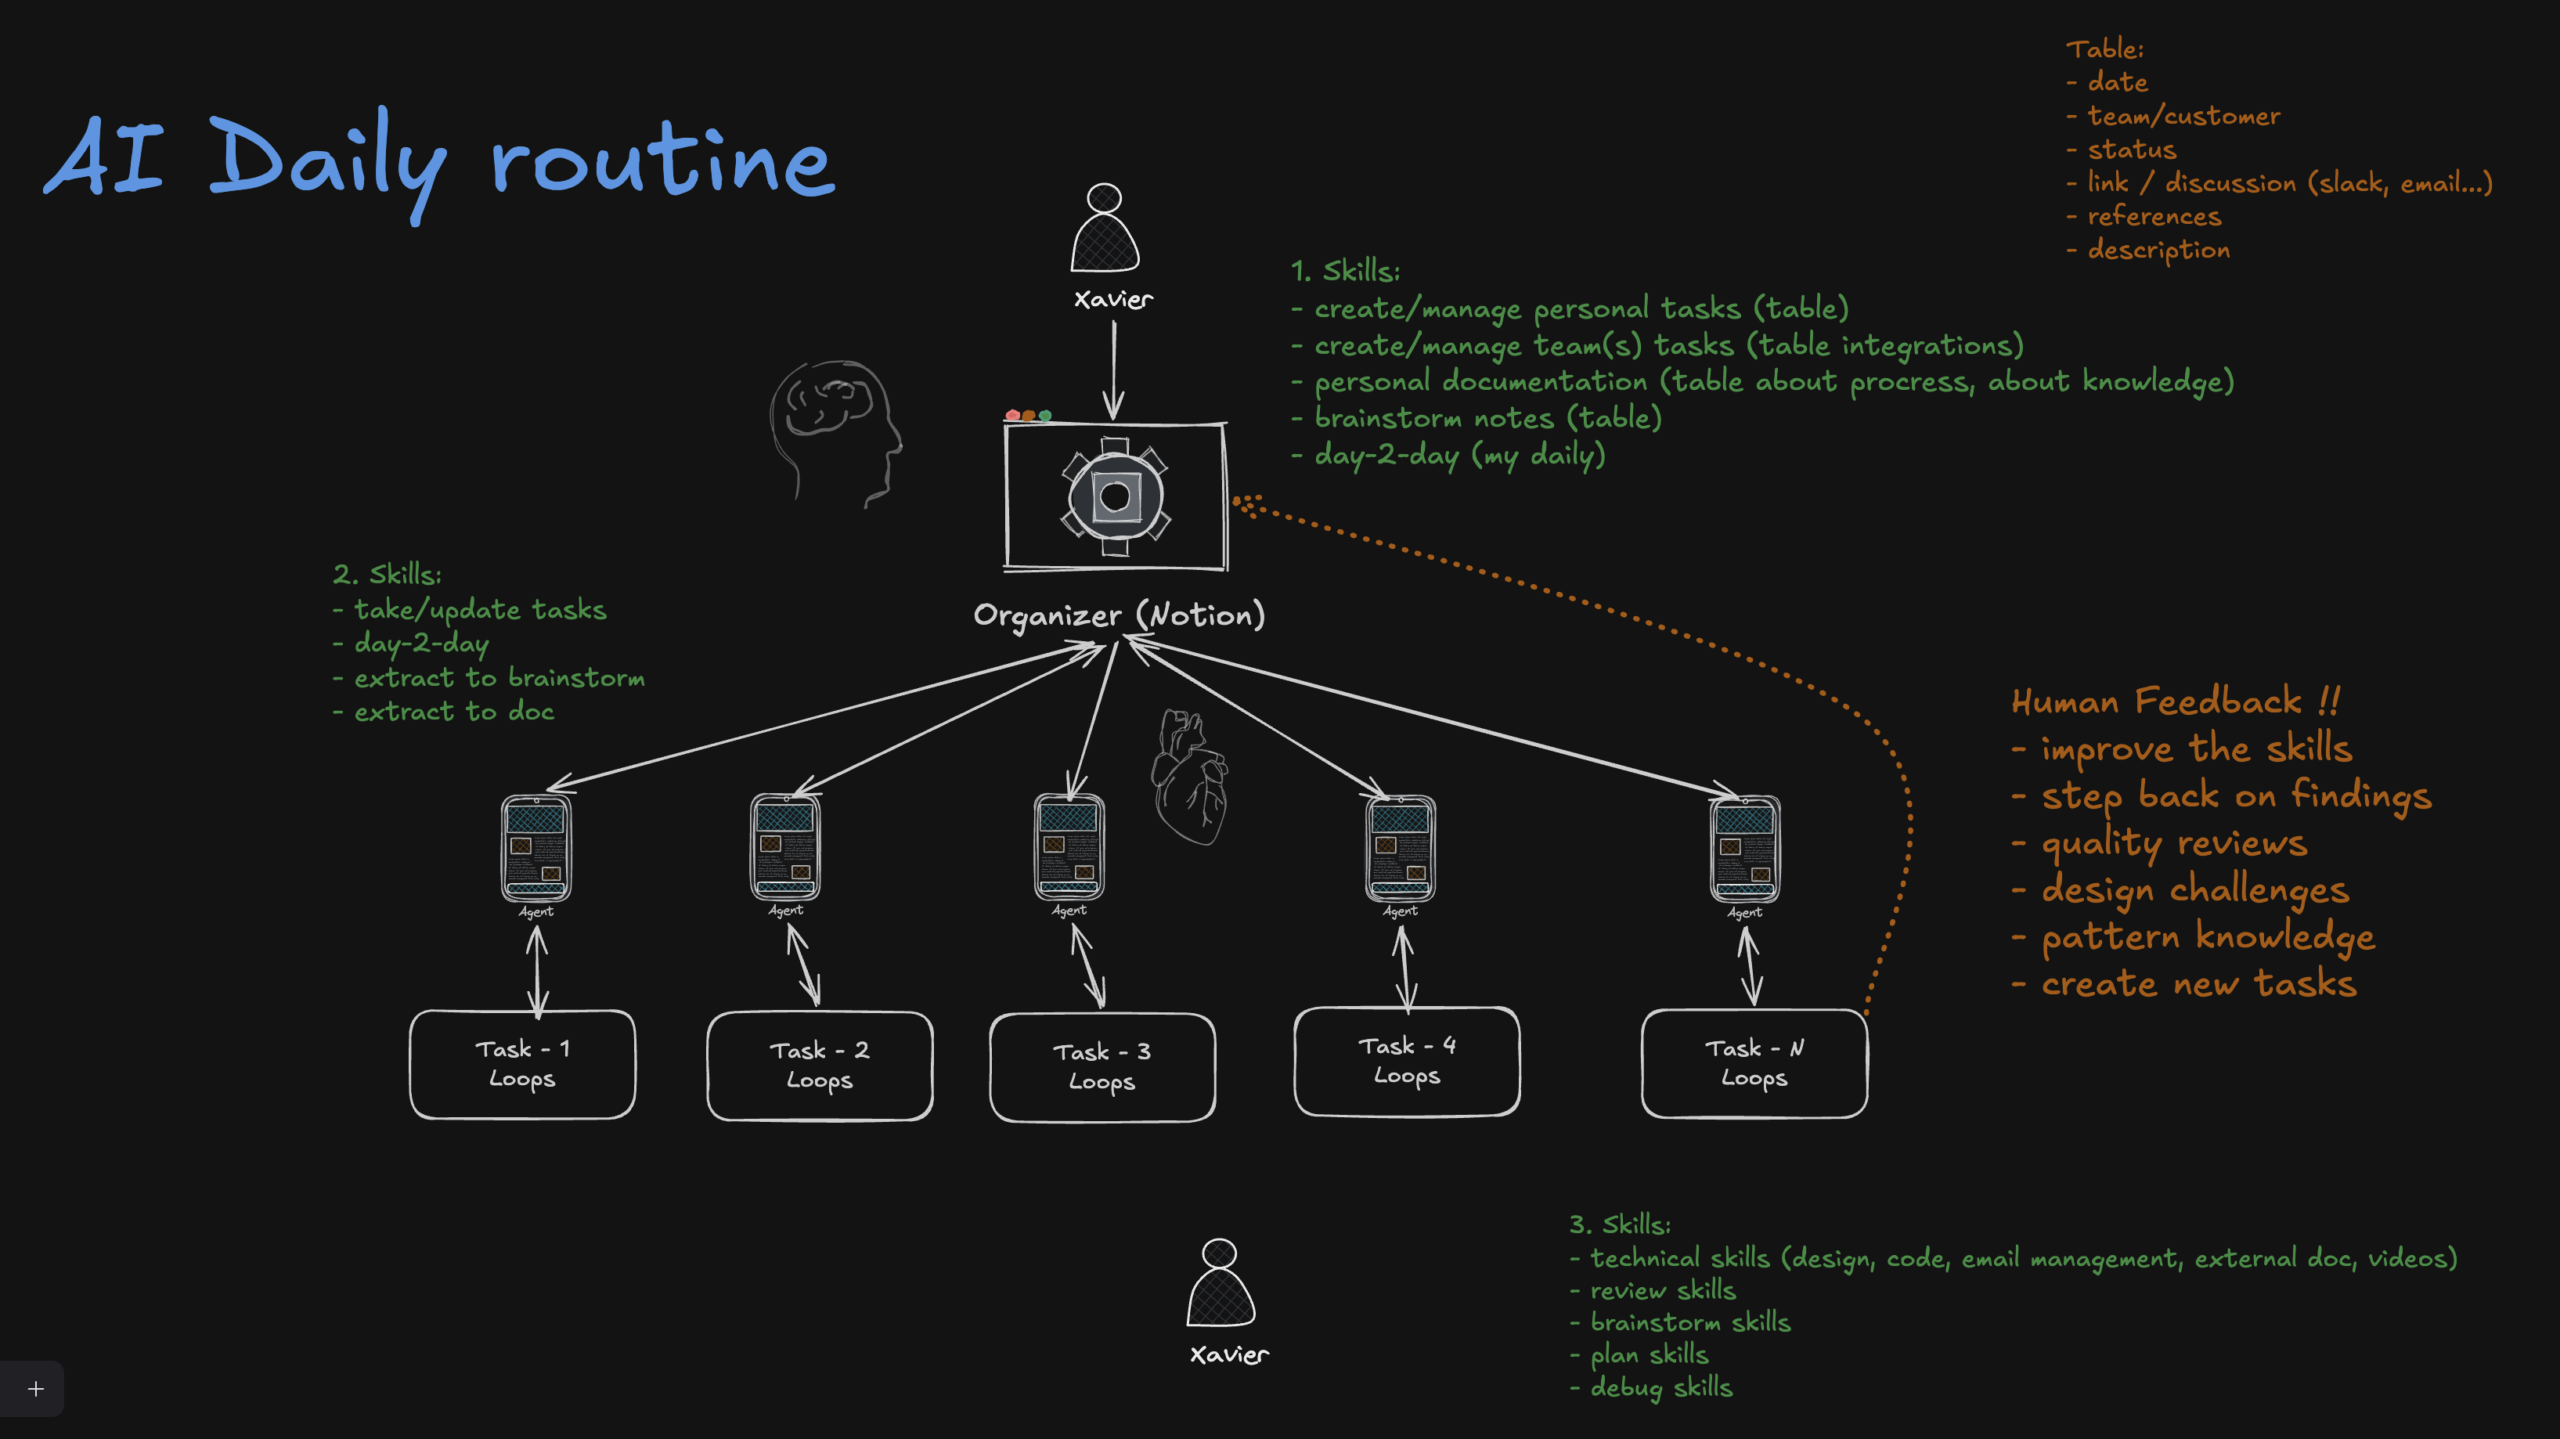
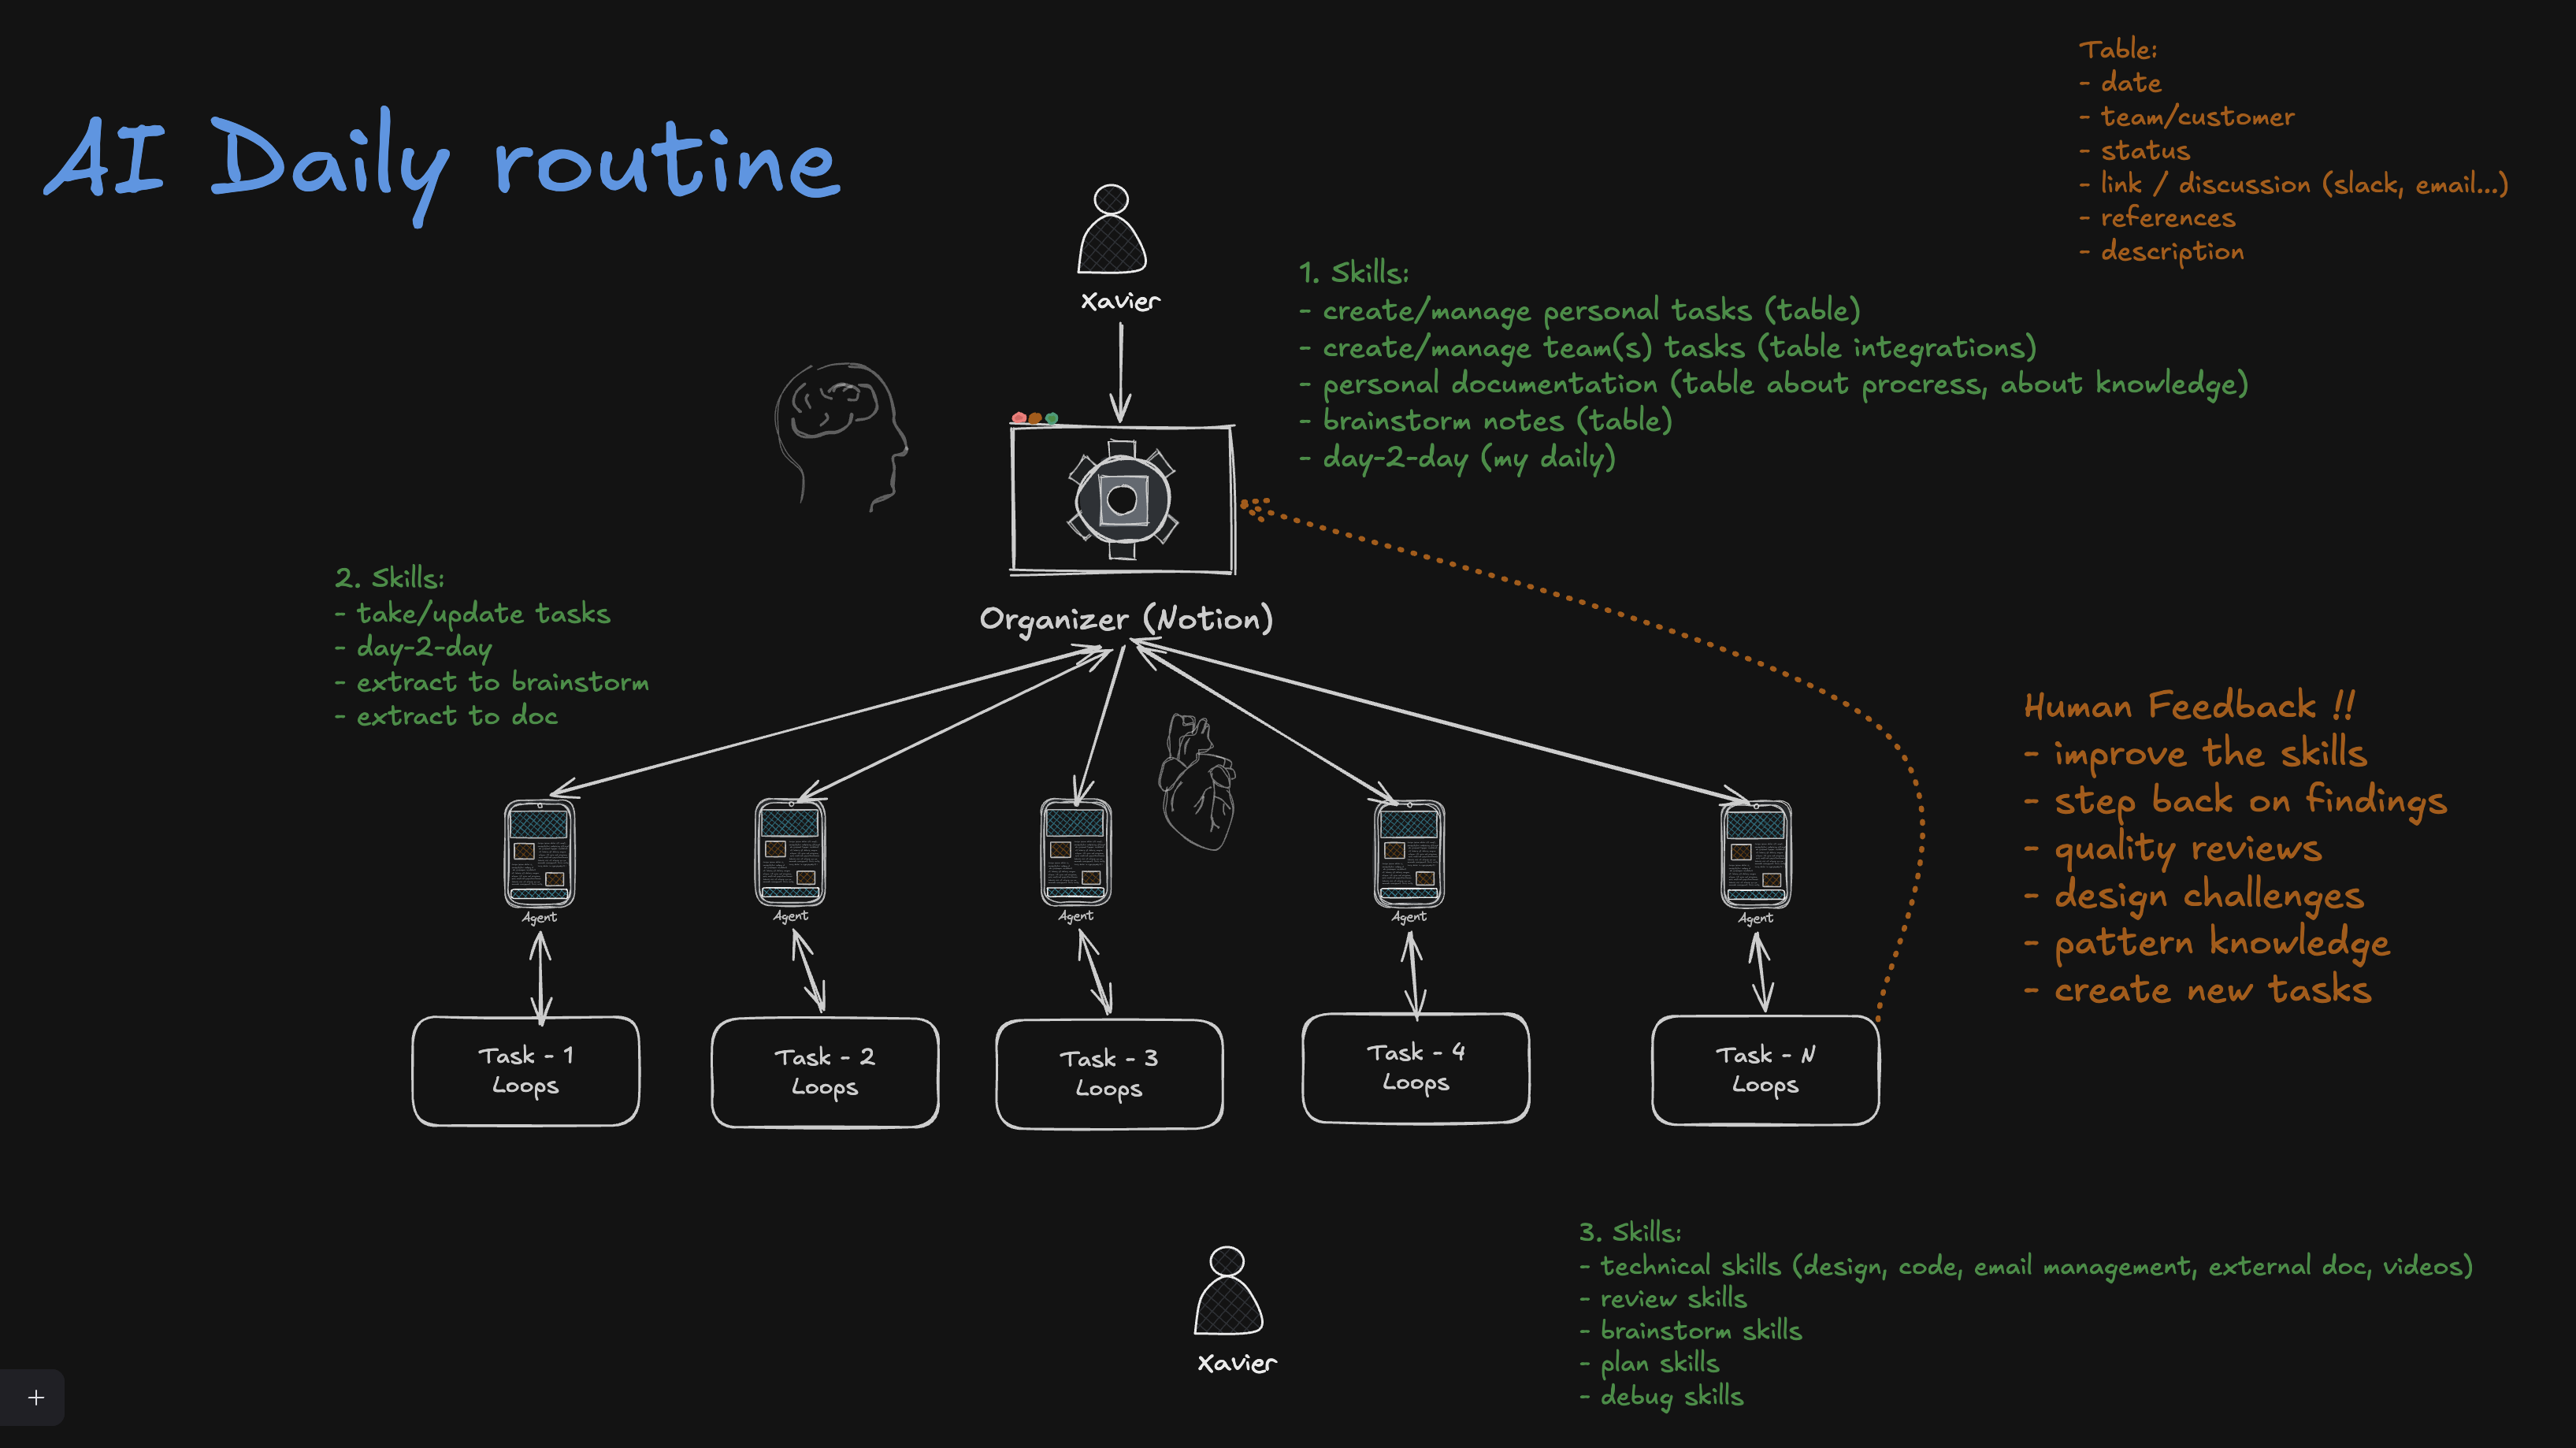
Le schéma local résume le workflow présenté : Notion sert d’organizer, des skills traitent plusieurs catégories d’entrées, puis des boucles d’agents produisent des résultats soumis au feedback humain.
L’angle est celui d’un retour d’expérience, pas celui d’une fonctionnalité garantie par un produit unique. Notion joue le rôle de hub pour les tâches et les connaissances (09:47). Des Agent Skills spécialisés transforment ensuite des messages, discussions ou notes en objets structurés. Plusieurs agents peuvent prendre en charge des tâches bornées, tandis que l’humain garde la main sur la qualité, les arbitrages et les actions sensibles.
OpenCode correspond dans ce dispositif à un agent de code open source utilisable dans un terminal, une application desktop ou un IDE (documentation OpenCode : opencode.ai). La vidéo cite aussi d’autres coding agents et des connexions MCP ou navigateur (25:07). Il faut donc lire cette routine comme une architecture adaptable, et non comme une dépendance exclusive à OpenCode.
Objectif
Le problème traité est concret : une journée produit des informations dans Slack, les emails, les échanges oraux, les dépôts de code et les outils de suivi. Sans méthode commune, ces éléments restent dispersés, vieillissent ou perdent leur contexte. La vidéo insiste d’ailleurs sur la date, la version et la qualité des connaissances enregistrées (15:37).
La routine proposée cherche à établir une chaîne de travail lisible :
- centraliser les demandes personnelles, d’équipe ou de clients dans Notion (13:30) ;
- convertir les entrées non structurées en tables exploitables avec un LLM (19:51) ;
- confier des opérations précises à des skills capables de créer, mettre à jour ou fermer des tâches via des connexions MCP (20:30) ;
- exécuter plusieurs boucles d’agents dans des limites définies (23:39) ;
- relire les sorties, demander des corrections et réinjecter le feedback dans les skills (41:18).
Cette organisation couvre aussi la capture de brainstorms (16:15), le journal quotidien (17:38) et l’analyse rétrospective de motifs récurrents (18:24). Elle ne suppose pas une autonomie totale. La vidéo pose au contraire des limites volontaires dès 08:09, puis décrit des boucles autonomes encadrées par le feedback humain à 26:00.
Liens utiles
- Vidéo : REX-AI, ma routine de travail avec l’IA
- Documentation OpenCode
- Releases OpenCode
- Spécification Agent Skills
- Architecture MCP
- Spécification MCP du 28 juillet 2026
- Vue d’ensemble de Notion MCP
- Bonnes pratiques de sécurité Notion MCP
- Playwright MCP
- Dépôt Playwright MCP
- Linear MCP
- Atlassian Rovo MCP
- Outils pris en charge par Atlassian Rovo MCP
- Site officiel de cmux
- Dépôt cmux
Installation
Parmi les chemins d’installation documentés, cet article retient le script officiel et npm (documentation OpenCode : opencode.ai).
La page officielle des releases affichait la version v1.18.30 lors de la consultation du 13 septembre 2026 (releases OpenCode : github.com). Cette information situe la documentation consultée, sans présumer de la version disponible au moment où le lecteur suivra l’article.
curl -fsSL https://opencode.ai/install | bash
npm install -g opencode-ai
Une fois installé, le client se lance avec :
opencodeDans un projet, /init analyse le projet et crée AGENTS.md à la racine, le fichier qui donne aux agents des repères sur le dépôt et ses conventions (documentation OpenCode : opencode.ai).
/initPour créer un agent dédié, OpenCode fournit la commande suivante (documentation des agents OpenCode : opencode.ai) :
opencode agent createCette même documentation distingue notamment les agents Plan et Build et décrit leurs permissions. Cette séparation aide à réserver l’écriture ou l’exécution aux agents qui en ont réellement besoin.
Les skills suivent la spécification Agent Skills. Chaque skill possède un fichier SKILL.md avec au minimum un name et une description en YAML. Il peut aussi embarquer des scripts, des références et des assets, chargés selon un principe de progressive disclosure (spécification Agent Skills : agentskills.io). Un skill peut être validé avec la commande documentée :
skills-ref validate ./my-skillPour un serveur MCP protégé par OAuth dans OpenCode, les opérations documentées sont :
opencode mcp auth my-oauth-server
opencode mcp list
opencode mcp logout my-oauth-server
Ces commandes servent respectivement à lancer l’authentification, afficher les serveurs configurés et supprimer les identifiants enregistrés (documentation MCP d’OpenCode : opencode.ai).
Notion propose un endpoint MCP hébergé à https://mcp.notion.com/mcp, avec OAuth et application des permissions de l’utilisateur connecté (guide de connexion Notion MCP : developers.notion.com). Le branchement exact dépend toutefois du client MCP retenu et de sa configuration.
Notions et concepts
Définitions essentielles
Skill. Un skill est un ensemble d’instructions réutilisables qui décrit une capacité spécialisée pour un agent, avec des métadonnées et, si nécessaire, des scripts, références ou assets. La spécification Agent Skills formalise notamment le fichier SKILL.md, tandis qu’OpenCode explique comment découvrir et charger ces capacités (spécification Agent Skills, documentation des skills OpenCode).
MCP. Le Model Context Protocol est un protocole qui standardise les échanges entre un host, ses clients et des serveurs fournissant du contexte ou des capacités. Son architecture permet notamment d’exposer des tools, resources et prompts à travers des interfaces définies (architecture MCP).
Knowledge base. Une knowledge base est un corpus organisé, sélectionné et interrogeable de sources et de contexte que les humains et les agents peuvent consulter. Dans le workflow de la vidéo, Notion tient ce rôle de hub à 09:47, avec une vigilance explicite sur la qualité des sources à 32:13.
Agent de code. Un agent de code est un agent qui intervient sur des tâches logicielles en combinant un modèle, le contexte du projet, des tools et des permissions définies. OpenCode documente cette organisation ainsi que la séparation de rôles comme Plan et Build (documentation OpenCode, documentation des agents OpenCode).
OpenCode. OpenCode est un agent de code open source utilisable depuis un terminal, une application desktop ou un IDE. Il fournit l’environnement dans lequel le modèle reçoit le contexte et mobilise les outils autorisés pour traiter une tâche logicielle (documentation OpenCode).
Harness. Dans cet article, le harness désigne le cadre d’exécution placé autour du modèle : instructions, contexte, tools, permissions, boucles d’orchestration et étapes de validation. Il s’agit d’un concept de travail pour décrire l’ensemble qui pilote les agents, et non d’une primitive formelle de MCP (documentation des agents OpenCode, architecture MCP).
Notion comme organizer et base de connaissances
Dans la routine montrée, Notion est le point de rassemblement. Les tables contiennent des champs tels que la date, l’équipe, le statut, le lien, les références et la description (22:54). Les skills ne remplacent pas ce modèle de données. Ils traduisent une entrée libre vers ce modèle, puis l’utilisent pour retrouver ou mettre à jour l’information.
Depuis l’évolution de l’API Notion introduite après 2025, une distinction existe entre une database, qui joue le rôle de conteneur, et ses data sources, qui portent les propriétés et les données interrogées (guide Notion sur les databases : developers.notion.com, FAQ de migration du 3 septembre 2025 : developers.notion.com). Les pages constituent les lignes d’une data source et leurs valeurs se conforment aux propriétés définies par celle-ci (référence des propriétés Notion : developers.notion.com). Cette nuance compte lors de l’écriture d’un skill ou d’une intégration qui crée des tâches.
Agent Skills et spécialisation
Un Agent Skill décrit une capacité ciblée dans SKILL.md, avec des ressources optionnelles. La progressive disclosure permet au client de découvrir d’abord le nom et la description, puis de charger les instructions ou fichiers nécessaires au moment où le skill est choisi (spécification Agent Skills : agentskills.io).
Dans le workflow de la vidéo, cette spécialisation sépare par exemple les tâches personnelles, les tâches d’équipe, la documentation, les brainstorms et le journal quotidien. Ce découpage est présenté comme une pratique de travail dans la vidéo, pas comme une garantie native de la spécification.
MCP comme couche de connexion
MCP organise les échanges entre un host, des clients et des serveurs. Les serveurs peuvent exposer des tools, des resources et des prompts. Les messages reposent sur JSON-RPC 2.0 et les transports standards incluent stdio et Streamable HTTP (architecture MCP : modelcontextprotocol.io, spécification MCP : modelcontextprotocol.io). Le mécanisme d’elicitation permet aussi à un serveur de demander des informations complémentaires à l’utilisateur.
Cette architecture rend possible la connexion d’un agent à Notion, Linear, Atlassian ou un navigateur. Elle ne donne pas automatiquement à l’agent tous les droits. Chaque serveur, chaque client et chaque compte conserve son propre modèle d’autorisation.
Sécurité et contrôle humain
Une routine agentique doit appliquer le moindre privilège. Il vaut mieux limiter chaque agent aux espaces, tools et opérations nécessaires, puis séparer la lecture de l’écriture quand le serveur le permet. Notion MCP agit avec les permissions de l’utilisateur authentifié, ce qui rend le choix du compte et des pages accessibles déterminant (sécurité Notion MCP : developers.notion.com).
Le contenu distant reçu par MCP doit être considéré comme non fiable. Une page, un ticket ou un document peut contenir une prompt injection destinée à détourner les instructions de l’agent. Les données peuvent aussi être transmises à des services externes selon le client, le modèle et les serveurs utilisés. Les secrets, données clients et documents internes demandent donc une revue explicite des flux et des politiques de conservation.
Les écritures, suppressions et autres actions destructives devraient rester soumises à confirmation humaine. La documentation de sécurité Notion recommande notamment une validation avant les opérations d’écriture sensibles (sécurité Notion MCP : developers.notion.com). Playwright MCP précise pour sa part qu’il ne constitue pas une frontière de sécurité. Un navigateur piloté par agent doit être isolé et ne recevoir que les accès nécessaires (documentation Playwright MCP : playwright.dev).
Parallélisation bornée et feedback
La vidéo présente plusieurs boucles de tâches exécutées en parallèle, mais dans un périmètre borné (23:39). Le suivi humain porte sur les résultats, les mises à jour de tâches et le journal quotidien (27:24). Les revues sont intégrées au workflow (36:30), tout comme des skills de planning et de debugging (37:54).
L’amélioration vient alors d’une boucle simple : relire, signaler l’erreur, corriger la sortie, puis ajuster le skill ou ses références. La vidéo insiste aussi sur la nécessité de relire et de maintenir sa propre compréhension du système (38:35).
Commandes
Les exemples ci-dessous reprennent uniquement les commandes documentées dans les sources officielles citées.
OpenCode
curl -fsSL https://opencode.ai/install | bash
npm install -g opencode-ai
opencode
opencode agent create
opencode mcp auth my-oauth-server
opencode mcp list
opencode mcp logout my-oauth-server/initAgent Skills
skills-ref validate ./my-skillPlaywright MCP
Playwright documente un lancement direct, un serveur sur le port 8931 et l’utilisation du navigateur Chrome. Le mode headed est utilisé par défaut (documentation Playwright MCP : playwright.dev).
npx @playwright/mcp@latest
npx @playwright/mcp@latest --port 8931
npx @playwright/mcp@latest --browser=chrome
Linear MCP
Linear publie un endpoint MCP principal à https://mcp.linear.app/mcp ainsi qu’un endpoint en lecture seule. Sa documentation donne notamment ces exemples pour Claude et Codex (documentation Linear MCP : linear.app) :
claude mcp add --transport http linear-server https://mcp.linear.app/mcp
codex mcp add linear --url https://mcp.linear.app/mcp
Atlassian documente séparément les outils de son serveur Rovo MCP pour Jira et Confluence (documentation Atlassian Rovo MCP : developer.atlassian.com, liste des outils : developer.atlassian.com). Aucune commande supplémentaire n’est ajoutée ici, afin de ne pas extrapoler au-delà des exemples fournis.
Demo
Le scénario suivant reformule le déroulé présenté dans la vidéo. Il décrit une première journée de travail possible, avec Notion comme hub, des skills spécialisés et plusieurs agents. Il ne signifie pas que l’ensemble fonctionne sans configuration, ni que toutes les étapes doivent être automatisées.
Flux général : une demande arrive depuis un email, Slack ou une discussion. Un skill identifie sa catégorie et prépare une entrée structurée dans Notion. L’humain vérifie les champs et autorise l’écriture. Une tâche validée peut ensuite être confiée à un agent adapté, éventuellement en parallèle d’autres tâches indépendantes. Les résultats reviennent dans le hub sous forme de statut, liens, références, documentation ou éléments de brainstorm. Une revue humaine ferme la boucle et fournit le feedback utile à l’évolution du skill.
Préparation du run
La première étape consiste à définir la structure Notion avant de brancher les agents. Une data source de tâches peut reprendre les champs visibles dans la vidéo : date, équipe, statut, lien, références et description (22:54). D’autres data sources peuvent séparer le journal quotidien, les brainstorms et la documentation si leurs cycles de vie diffèrent.
Chaque propriété doit avoir un sens précis. Le statut décrit l’avancement, le lien pointe vers la source ou le livrable, les références conservent les preuves consultées, et la description contient la demande normalisée. Une date de collecte et, pour la documentation, une version ou une date de validité limitent le risque de réutiliser une connaissance périmée. Cette préoccupation apparaît dans la vidéo à 15:37.
Vient ensuite la configuration des accès. Le compte Notion doit voir uniquement les pages nécessaires. Les connexions Linear, Atlassian, navigateur ou dépôt sont activées tâche par tâche. Un agent destiné au brainstorm n’a pas besoin d’un droit de suppression dans le suivi de projet. Les opérations d’écriture restent soumises à confirmation.
Enfin, les skills sont préparés avec une responsabilité claire : transformer un message en tâche, extraire un brainstorm, produire une fiche documentaire ou compléter le day-to-day log. Les critères de sortie, les sources autorisées et les cas exigeant une validation humaine sont écrits dans leurs instructions. La vidéo montre notamment l’extraction de brainstorm à 29:30 et l’extraction documentaire à 31:33.
Lancement et parallélisation
Une entrée non structurée est d’abord fournie au skill correspondant. Celui-ci propose les valeurs de la ligne Notion, sans les écrire silencieusement. L’utilisateur contrôle la catégorie, l’équipe, la date, le statut et les liens, puis confirme la création. Ce passage reprend la transformation LLM décrite à 19:51, tout en conservant une validation explicite.
Après qualification, chaque tâche reçoit une boucle d’exécution adaptée. Une tâche de code peut partir vers OpenCode ou un autre coding agent. Une recherche documentaire peut interroger les sources officielles, puis vérifier les affirmations contre les dépôts ou le runtime disponible, comme recommandé dans la vidéo à 33:36. Une tâche web peut mobiliser Playwright MCP dans un environnement isolé.
Les tâches réellement indépendantes peuvent être lancées en parallèle. La limite porte sur leur nombre, leurs permissions et leur périmètre. Une boucle ne doit pas modifier les mêmes pages ou fichiers qu’une autre sans coordination. Cette parallélisation bornée correspond au principe présenté à 23:39, et non à une délégation générale de la journée.
Suivi et validation humaine
Pendant l’exécution, chaque agent restitue des éléments vérifiables : statut courant, liens consultés, références, fichiers produits, points incertains et décisions demandées. Ces informations alimentent la tâche et le day-to-day log. La mise à jour des tâches et du journal est montrée à 27:24.
La validation humaine compare la sortie à la demande initiale et aux sources. Pour une documentation, elle contrôle la version, la date et la qualité des références (32:13). Pour une modification de code, elle relit le diff, les tests et le comportement observé. Pour une écriture dans Notion, Linear ou Jira, elle vérifie les champs et confirme l’action. Toute instruction inattendue provenant d’un contenu MCP est traitée comme une possible prompt injection.
Si le résultat est incomplet, le feedback doit être concret : champ manquant, source trop ancienne, format incorrect, action non autorisée ou critère d’acceptation non satisfait. L’agent peut reprendre sa boucle dans le même périmètre. Un changement de droits ou une suppression exige une nouvelle confirmation.
Sortie et réutilisation
À la fin du run, la tâche contient un statut final, un lien vers le livrable, les références retenues et une description mise à jour. Le journal conserve le déroulé utile à la rétrospective. Les idées distinctes sont extraites vers l’espace de brainstorm, tandis que la documentation validée rejoint la zone prévue avec sa date et sa version.
La réutilisation ne consiste pas à copier aveuglément une ancienne réponse. Une prochaine boucle peut rechercher des cas similaires, identifier des motifs récurrents dans le journal à 18:24, puis vérifier que les sources sont encore valides. Le feedback accumulé sert enfin à préciser les instructions du skill, ses critères de sortie ou ses références, conformément à la boucle d’amélioration présentée à 41:18.
Les commandes citées dans cet article ont été vérifiées dans les documentations officielles indiquées. Le workflow complet, avec toutes ses connexions et ses boucles d’agents, n’a pas été exécuté de bout en bout pour cet article.
Conclusion
Ce REX présente une routine où Notion organise les tâches et les connaissances, tandis que des Agent Skills transforment les entrées libres en objets structurés. MCP relie les agents aux services nécessaires, et plusieurs boucles peuvent avancer en parallèle lorsqu’elles restent indépendantes et bornées.
Le point central n’est pas l’autonomie maximale. La méthode décrite conserve des validations humaines pour la qualité, les permissions, les écritures et les actions destructives. Elle demande aussi de dater les connaissances, de citer les sources et de vérifier les sorties contre les dépôts ou le runtime quand cela est possible. Le feedback ne sert donc pas seulement à corriger un résultat ponctuel. Il affine progressivement les skills et maintient la compréhension humaine du système.
Transparence IA
Ce contenu a été partiellement rédigé ou structuré avec l aide d outils d intelligence artificielle, puis relu, corrigé et complété par l auteur avant publication.