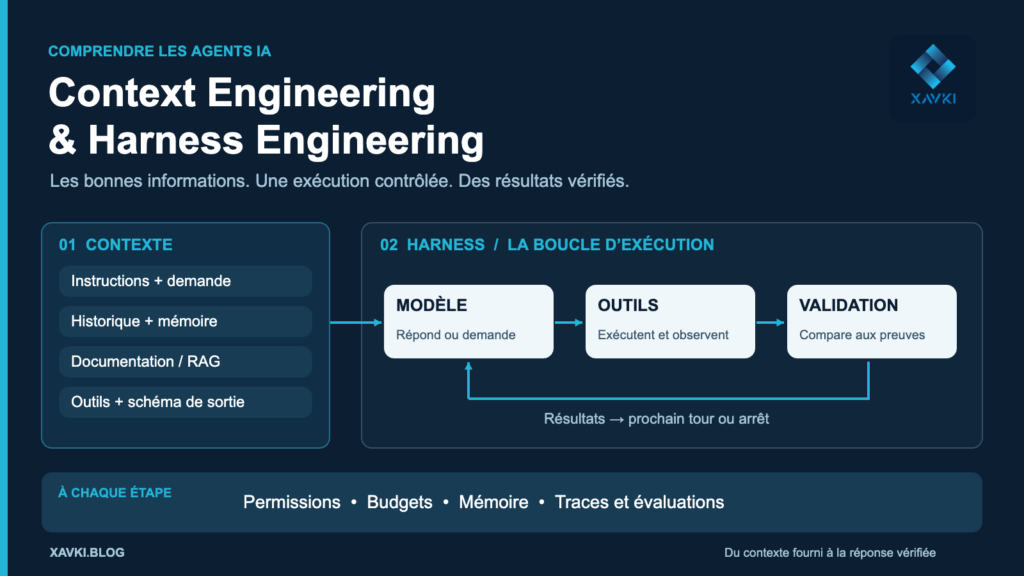

Un agent IA ne se résume pas à un modèle accompagné d’un bon prompt. Il faut aussi sélectionner les informations qu’il reçoit, exécuter ses demandes d’outils, conserver les observations et vérifier ses réponses. Le Context Engineering organise ce que le modèle voit ; le Harness Engineering organise le logiciel qui le fait travailler. Voici comment ces deux disciplines s’articulent, avec un exemple de comparaison entre documentation et configuration réelle d’un service.
TL;DR
- Le Context Engineering consiste à fournir au modèle les bonnes instructions, les bonnes informations et les bons outils pour l’appel en cours.
- Le Harness Engineering consiste à construire l’environnement logiciel qui prépare ces appels, exécute les actions, contrôle les résultats et décide de continuer ou de s’arrêter.
- Le RAG apporte des passages documentaires ; un outil peut apporter une observation de l’état réel. Ces sources ne sont pas interchangeables.
- Un appel d’outil produit par le modèle reste une demande : l’application doit le valider, l’exécuter et renvoyer son résultat.
- Un JSON conforme à un schéma peut contenir une valeur fausse. La validation doit aussi confronter les valeurs aux preuves disponibles.
- Les traces et les évaluations permettent de comprendre les échecs et d’en faire des cas de non-régression.
La vidéo de référence
Cet article accompagne la vidéo de xavki « Contexte & Harness Engineering », d’une durée de 49 minutes et 39 secondes. Sa description renvoie aux dépôts GitLab pour retrouver les slides et les codes des projets.
Le support correspondant est le fichier 01-context-and-harness/context-harness-xavki.pdf. Ses 28 pages suivent deux étapes : les composants du contexte, puis les mécanismes d’exécution d’un agent. C’est cette progression que nous allons reprendre.
Le support PDF : contexte et harness en 28 slides
Retrouvez le support complet ci-dessous pour suivre les exemples et les schémas pendant la lecture de l’article.
Ouvrir ou télécharger le support PDF — si votre navigateur mobile ne propose pas la lecture intégrée, utilisez ce lien pour consulter les slides.
Context Engineering : qu’est-ce que le contexte d’un modèle ?
Le Context Engineering, ou ingénierie du contexte, consiste à concevoir la préparation des informations et des capacités présentées au modèle à un instant donné. Le contexte comprend donc davantage que la dernière question de l’utilisateur.
Dans une application conversationnelle, un appel peut réunir des instructions système, un historique, une préférence sauvegardée, des passages documentaires, des descriptions d’outils et un format de réponse attendu. Le travail d’ingénierie porte sur leur sélection, leur provenance et leur présentation.
La page 2 du support reprend les sept composants présentés par Philipp Schmid dans son article sur le Context Engineering. L’idée importante est le caractère dynamique du contexte : on prépare ce qui est utile à la tâche et au tour courant, plutôt que d’envoyer systématiquement toutes les informations disponibles.
Prenons la demande utilisée dans les slides : comparer le timeout documenté et le timeout actif du service api. Une question bien formulée ne suffit pas. Le modèle doit disposer du guide du service pour connaître la valeur documentée et d’une observation de la configuration pour connaître la valeur active.
Sans ces deux éléments, une réponse précise peut n’être qu’une supposition.
Prompt, contexte et harness : quelles différences ?
Ces trois notions interviennent à des niveaux complémentaires.
| Approche | Question principale | Exemple pour le service api |
|---|---|---|
| Prompt Engineering | Comment formuler la demande et les consignes ? | Demander de distinguer les valeurs documentées et observées. |
| Context Engineering | Quelles informations et capacités présenter maintenant ? | Ajouter le passage du guide et décrire l’outil read_timeout. |
| Harness Engineering | Comment exécuter, contrôler et poursuivre le travail ? | Vérifier l’appel, lire la configuration, renvoyer l’observation et valider la réponse. |
La frontière n’est pas une séparation étanche. Le harness assemble précisément le contexte qui sera envoyé au modèle. Il exploite ensuite la réponse pour préparer la suite.
Cette distinction aide surtout à diagnostiquer un problème. Si le guide manque, il faut examiner la préparation du contexte. Si la bonne fonction est demandée mais jamais exécutée, il faut examiner le traitement des outils. Si une valeur inventée est acceptée malgré une lecture en échec, il faut examiner la validation.
Les sept composants du Context Engineering
1. Le system prompt : les règles communes
Le message système contient les consignes qui s’appliquent aux requêtes. Dans le support, la règle centrale demande de distinguer les valeurs documentées des valeurs observées et de signaler les valeurs inconnues.
Ce choix est concret : il évite de traiter une valeur présente dans un guide comme une preuve de la configuration actuellement déployée. Il définit aussi le comportement attendu quand une source manque.
2. Le user prompt : la demande actuelle
Le message utilisateur porte la tâche à accomplir : comparer les deux timeouts pour le service api. Dans l’exemple des pages 3 et 4, les messages sont envoyés dans l’ordre system, puis user.
La réponse du modèle arrive ensuite dans un message assistant. À ce stade, si aucun guide ni résultat de lecture n’a été fourni, les deux valeurs restent inconnues.
3. L’historique : sélectionner les échanges utiles
L’application prépare les messages du tour suivant. Elle peut conserver la question initiale, la réponse précédente et une précision comme « commence par la valeur documentée ».
Lorsqu’un outil intervient, il faut aussi conserver la demande de l’assistant et le résultat associé. Un résumé qui oublie le service concerné, la version du guide ou le statut d’une lecture peut rendre le prochain appel ambigu.
4. La mémoire persistante : rappeler une information enregistrée
La page 6 illustre une préférence de langue stockée dans PostgreSQL. L’application la récupère à partir de l’identité de l’utilisateur, puis l’ajoute au contexte si elle existe.
La mémoire persistante n’est donc pas une propriété magique du modèle. Dans cet exemple, c’est une donnée conservée par l’application, relue puis réintroduite au moment opportun. L’historique d’une conversation et une préférence sauvegardée n’ont pas le même cycle de vie.
5. Le RAG : récupérer des passages pertinents
Le RAG, pour Retrieval-Augmented Generation, ajoute une étape de recherche avant la génération. Le support utilise PostgreSQL avec pgvector et le modèle d’embedding mistral-embed.
La question est transformée en vecteur pour retrouver des passages proches. La requête des slides filtre le corpus autorisé, trie par distance cosinus et limite le résultat à trois passages :
SELECT id, content
FROM passages
WHERE corpus_id = %s
ORDER BY embedding <=> %s::vector
LIMIT 3
Il s’agit d’un extrait destiné à une requête paramétrée avec psycopg, pas d’une commande autonome à coller telle quelle dans psql. Il suppose une table de passages déjà alimentée et des embeddings compatibles, générés avec le même modèle pour les documents et la question.
L’opérateur <=> calcule la distance cosinus, comme le précise la documentation de pgvector. Le modèle de génération reçoit ensuite le texte des passages et leurs identifiants. Le vecteur sert à la recherche ; il ne remplace pas le contenu documentaire dans la requête de génération.
6. Les outils : décrire les opérations disponibles
Un outil décrit une capacité offerte au modèle. Dans le support, read_timeout accepte un argument service, limité à api, et annonce une lecture du timeout actif en secondes.
La description inclut le nom de la fonction, son objectif et le schéma de ses arguments. Elle permet au modèle de demander une opération. L’implémentation qui lit réellement la configuration reste du côté de l’application.
7. La sortie structurée : définir le contrat de réponse
Le support utilise Pydantic pour exprimer la structure des deux valeurs :
from pydantic import BaseModel, Field

class Timeouts(BaseModel):
    documented_s: int | None = Field(ge=0)
    active_s: int | None = Field(ge=0)
Les deux champs sont requis et acceptent un entier positif ou nul, ou None si la valeur est inconnue. Dans une représentation JSON, None devient null.
Ce contrat rend la réponse exploitable par du code. Il ne prouve pas que les nombres correspondent à la documentation ou à l’environnement observé. Cette seconde vérification appartient au harness.
Harness Engineering : le logiciel qui pilote l’agent
Le Harness Engineering, ou ingénierie du harnais d’exécution, concerne le logiciel qui entoure le modèle et organise son travail. La seconde partie du support PDF, à partir de la page 13, le présente comme l’ensemble qui prépare les appels, exécute les actions, conserve leurs résultats et décide de poursuivre ou d’arrêter.
Le modèle et le harness sont interdépendants. Le premier produit une réponse ou une demande d’action à partir de ce qu’il reçoit. Le second détermine les informations accessibles, les opérations réellement possibles et les conditions d’acceptation du résultat.
La page 15 propose neuf couches, dans une représentation adaptée de Shivani Virdi, Neosage :
- La boucle de l’agent : enchaîner les tours et appliquer les conditions d’arrêt.
- Les outils : exécuter les opérations autorisées et produire des observations.
- Le contexte : construire les messages utiles à chaque appel.
- La mémoire : conserver les faits, décisions et états nécessaires.
- Les instructions et skills : fournir les règles et procédures adaptées.
- Les sous-agents : déléguer une tâche ciblée et récupérer ses preuves.
- Les permissions : contrôler les accès et l’environnement d’exécution.
- Les garde-fous : appliquer des contrôles avant et après les appels.
- Les traces et évaluations : expliquer les exécutions et vérifier les régressions.
Cette grille sert à lire une architecture. Elle n’impose pas de déployer neuf services différents : plusieurs responsabilités peuvent être portées par le même programme.
Du tool calling à une observation vérifiable
Le tool calling devient plus clair si l’on suit le cycle complet des pages 9 à 11.
D’abord, l’application déclare read_timeout dans la liste des outils. Ensuite, le modèle renvoie une demande contenant un nom de fonction, des arguments sérialisés et un identifiant d’appel. L’application inspecte ces éléments avant d’exécuter la lecture.
Dans l’exemple, elle vérifie notamment que la fonction demandée est bien read_timeout et que les arguments correspondent exactement à {"service": "api"}. Elle lit alors timeout_s dans la configuration active.
Le résultat est renvoyé avec le rôle tool et le même tool_call_id. Le nouvel historique contient d’abord le message assistant qui a demandé l’action, puis le résultat de l’outil. Ce lien permet d’identifier quelle observation répond à quelle demande.
Il faut également représenter les échecs. Si la lecture dépasse son délai ou si l’accès est refusé, le harness doit renvoyer ce statut. Une absence d’observation ne devient pas une valeur par défaut : le timeout actif reste inconnu.
La boucle d’agent : continuer, accepter ou arrêter
La page 18 présente cette boucle minimale :
def run(messages, ask, execute, accept, max_turns=4):
    for _ in range(max_turns):
        reply = ask(messages)
        if reply.tool_calls:
            messages.append(reply)
            for call in reply.tool_calls:
                messages.append(execute(call))
        elif accept(reply):
            return "done", reply
        else:
            return "invalid_result", reply
    return "budget_exhausted", None
Ce code est un squelette pédagogique : ask, execute et accept sont des fonctions à fournir. La première appelle le modèle, la deuxième exécute et formate le résultat d’un outil, la troisième vérifie la réponse finale.
La limite max_turns encadre le nombre de tours du modèle. Le support demande aussi des limites distinctes pour le nombre d’actions et le temps écoulé. Un tour pouvant contenir plusieurs demandes d’outils, ces budgets ne sont pas équivalents.
La boucle montre aussi qu’une réponse finale n’est pas automatiquement un succès. Le harness peut la refuser si elle ne satisfait pas les critères attendus.
Skills, hooks, permissions et sandbox : quel rôle pour chacun ?
Un skill regroupe des instructions réutilisables pour une tâche. Dans notre exemple, la procédure consiste à consulter le guide, lire la configuration active et comparer les preuves. La page 16 propose de charger cette procédure à la demande, en complément des règles permanentes.
Un hook est une fonction appelée à un point précis de l’exécution. Avant l’action, il peut vérifier son nom et ses arguments. Après l’action, il peut filtrer des informations sensibles avant journalisation ou transmission.
Les permissions déterminent si l’utilisateur ou l’agent peut accéder à la ressource ciblée. Une sandbox fournit un environnement d’exécution isolé, avec des restrictions adaptées sur les fichiers, le réseau ou la durée.
Ces éléments répondent à des problèmes différents. La procédure explique comment travailler ; les contrôles d’exécution déterminent quelles actions sont acceptées et dans quelles conditions elles s’exécutent. Écrire une règle dans un prompt ne remplace pas son application dans le code.
Mémoire, checkpoints et sous-agents : conserver les bonnes preuves
La page 21 distingue trois formes d’état : la session, le profil et le checkpoint. La session conserve la question et les observations récentes. Le profil conserve des préférences propres à l’utilisateur. Le checkpoint enregistre l’avancement d’une exécution pour permettre sa reprise.
Pour une investigation, un checkpoint utile conserve notamment l’identifiant d’exécution, l’étape terminée et les références des preuves. Lors de la reprise, une configuration précédemment observée peut avoir changé : il faut vérifier si l’observation est encore actuelle.
Le support évoque aussi l’idempotence. Avant de rejouer une écriture, l’application doit vérifier si elle a déjà pris effet ou réutiliser une clé d’idempotence reconnue par le service.
La délégation à des sous-agents ajoute une autre question : qui contrôle la prochaine étape ? Dans un workflow explicite, le programme impose l’ordre des opérations. Dans une délégation, un agent parent confie par exemple la lecture du guide à un sous-agent et celle de la configuration à un autre.
Le résumé retourné doit conserver les preuves. Avant comparaison, les deux résultats doivent concerner le même service. Une synthèse bien rédigée sur le mauvais identifiant ne résout pas le problème initial.
Validation : un JSON valide peut contenir une valeur fausse
C’est l’un des points les plus utiles du chapitre. Un champ active_s égal à 30 satisfait le type entier et la contrainte positive de Pydantic. Pourtant, si la lecture a échoué, cette valeur n’est étayée par aucune observation.
La page 23 ajoute donc une validation métier :
def validate_active(output, observation):
    if observation["status"] != "ok":
        return output.active_s is None
    return output.active_s == observation["timeout_s"]
Si l’observation a échoué, seule une valeur inconnue est acceptable pour le timeout actif. Si la lecture a réussi, la réponse doit correspondre à la valeur observée. Renvoyer null malgré une lecture réussie n’est pas conforme non plus à cette règle.
La valeur documentée doit être vérifiée séparément, avec la bonne version du guide et l’identifiant du passage. On ne peut pas déduire le timeout documenté à partir de la seule configuration active, ni faire l’inverse.
Traces et évaluations : transformer un échec en test
Une trace utile relie l’entrée du modèle, l’appel d’outil, son résultat et la décision de validation. Dans les pages 24 et 25, un run_id permet de suivre l’exécution et le tool_call_id de rattacher l’observation à la demande.
On peut alors distinguer plusieurs causes : passage documentaire absent, outil en échec, observation mal transmise ou réponse finale incohérente avec les preuves.
Les évaluations reprennent ces situations avec des entrées figées : messages, passage du guide et observation simulée. Deux cas du support résument l’objectif :
- Lecture réussie à 30 secondes : accepter
30et rejeter les autres valeurs. - Lecture en timeout : accepter
nullet rejeter tout entier pour la valeur active.
On peut ensuite comparer deux versions sur leurs verdicts, valeurs non justifiées, appels d’outils et latences. Le coût devient un critère de comparaison supplémentaire, après vérification des comportements requis.
Premier exemple avec le SDK Python Mistral
Les pages 3 et 4 utilisent le client Python Mistral, une clé fournie par MISTRAL_API_KEY et le modèle mistral-small-latest. Le fragment ci-dessous rassemble leur initialisation et leur premier appel :
import os
from mistralai.client import Mistral

client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])
model = "mistral-small-latest"

system = {
    "role": "system",
    "content": (
        "Distinguish documented values from observed "
        "values. Flag any unknown value."
    ),
}
question = (
    "Compare the documented and active timeouts "
    "for the api service."
)
user = {"role": "user", "content": question}
messages = [system, user]

reply = client.chat.complete(model=model, messages=messages)
answer = reply.choices[0].message
Ce premier appel suppose le paquet mistralai installé et la clé configurée. Il ne contient encore ni recherche documentaire ni lecture de configuration. Il illustre la préparation des messages, pas une investigation complète.
Pour reproduire les étapes suivantes du support, il faut aussi préparer PostgreSQL, pgvector, le corpus de passages et l’accès à la configuration active. Les extraits des slides ne constituent pas, à eux seuls, un projet autonome prêt à lancer. Les appels API présentés ici n’ont pas été exécutés pour la rédaction de cet article.
Quand utiliser un harness plus élaboré ?
Le besoin devient visible dès qu’une tâche nécessite plusieurs observations, des actions, une reprise après interruption ou un contrôle métier des réponses. Comparer un guide et un environnement réel est déjà un bon exemple : la qualité dépend autant de l’acquisition des preuves que de leur interprétation.
Pour une transformation simple d’un texte entièrement fourni, un appel unique avec un contrat de sortie peut suffire. Une boucle agentique, des sous-agents ou une mémoire persistante doivent répondre à un besoin identifiable.
Les pages 26 et 27 situent plusieurs familles : LangGraph pour organiser des états et transitions, Prefect ou n8n pour orchestrer des étapes, OpenRouter pour router des requêtes de modèles, Promptfoo ou DeepEval pour les évaluations. Ces fonctions sont complémentaires ; le routage des requêtes ne prend pas, à lui seul, en charge l’état et les actions de l’application.
Pour prolonger le chapitre, le dépôt contient un laboratoire distinct : 02-demo-harness/README.md. Il compare cinq configurations d’agent sur un même incident Kubernetes : shell et kubectl, ajout d’un skill, collecteurs contrôlés, OpenSandbox, puis observabilité. Ce laboratoire offre une suite pratique à la grille de lecture présentée ici.
Liens utiles
- Vidéo « Contexte & Harness Engineering ».
- Dépôt GitLab ai-xavki-introduction.
- Support PDF du chapitre 01.
- Laboratoire Kubernetes du chapitre 02.
- Playlist AI Reflection, proposée sur la page de la vidéo.
- Context Engineering, par Philipp Schmid.
- Documentation Mistral AI.
- SDK Python Mistral et exemples d’utilisation.
- Documentation et code de pgvector.
- Communauté xavki sur Discord.
FAQ sur le Context Engineering et le Harness Engineering
Quelle différence entre Context Engineering et Prompt Engineering ?
Le Prompt Engineering travaille la formulation des demandes et consignes. Le Context Engineering organise aussi l’historique, la mémoire, les informations récupérées, les outils disponibles et le format de sortie pour chaque appel.
Qu’est-ce qu’un harness pour un agent IA ?
Un harness est le logiciel qui pilote l’exécution de l’agent : il prépare les appels au modèle, traite les outils, conserve les résultats, applique les contrôles et décide de poursuivre ou d’arrêter.
Le RAG suffit-il à connaître l’état réel d’un service ?
Un RAG documentaire apporte des passages issus de son corpus. Pour affirmer la valeur active d’une configuration, il faut une source représentant effectivement cet état, avec une provenance et une fraîcheur adaptées. Dans le chapitre, cette observation est fournie par read_timeout.
Le modèle exécute-t-il lui-même une fonction ?
Dans le mécanisme illustré par les slides, le modèle émet une demande structurée. L’application valide le nom et les arguments, exécute la fonction et renvoie le résultat avec le tool_call_id correspondant.
Pourquoi valider la réponse après Pydantic ?
Pydantic contrôle la structure, les types et les contraintes déclarées. Une validation métier doit encore vérifier que les valeurs correspondent aux passages documentaires et aux observations disponibles.
Faut-il obligatoirement utiliser des sous-agents ?
Non. Un workflow explicite ou une boucle simple peut suffire. Les sous-agents deviennent utiles lorsqu’une délégation ciblée apporte un bénéfice ; leurs résultats doivent rester reliés à leurs preuves et au bon objet métier.
Conclusion
Le Context Engineering et le Harness Engineering permettent de regarder un agent IA comme un système complet. Le premier organise ce que le modèle reçoit. Le second organise les actions, l’état et les vérifications qui donnent un sens opérationnel à ses réponses.
L’exemple du timeout résume cette articulation : retrouver le guide, lire la configuration, distinguer les deux sources, conserver l’inconnu lorsqu’une preuve manque et vérifier le résultat avant de le transmettre.
Pour comprendre un échec, deux questions constituent un bon point de départ : quelles preuves le modèle a-t-il reçues, et qu’a fait le harness ensuite ?
Transparence IA
Ce contenu a été partiellement rédigé ou structuré avec l aide d outils d intelligence artificielle, puis relu, corrigé et complété par l auteur avant publication.